Kimi API pricing 2026: precios oficiales por tokens, diferencia con la membresía de Kimi, modelos K3.1 Pro y K3, caché, Batch y cómo estimar el coste
Si buscas Kimi API pricing o el precio de la API de Kimi, lo más importante es una distinción que la propia documentación oficial insiste en subrayar: la inferencia de la API se cobra por uso, no con un plan de suscripción. Eso es distinto de la membresía de Kimi y de productos como Kimi Code. Pagar un plan de usuario no sustituye el saldo de tokens, y recargar la API no te convierte automáticamente en suscriptor del producto de consumo.
Esta guía en español resume los precios oficiales consultados el 20 de noviembre de 2026 en la plataforma de la API de Kimi y en su documentación de precios de inferencia, explica cómo se combinan entrada, salida y caché, y ayuda a estimar un coste sin inventar una cuota mensual que el producto no tiene. Si estás comparando otras APIs o planes, también puedes ver Grok pricing, precios de Claude, precios de Gemini y la guía de Google AI Studio en español. Más comparativas están en la central de precios de herramientas de IA. Para vídeo o voz, hay guías de HeyGen pricing y ElevenLabs pricing, que no deben mezclarse con el cobro por tokens de Kimi.
Los importes están en dólares estadounidenses por millón de tokens (1 MTok = 1.000.000), sin impuestos. El total final depende de tu jurisdicción y de lo que muestre la pasarela al recargar o al cerrar el ciclo de facturación. Comprueba siempre la tabla viva en platform.kimi.ai/docs/pricing/chat y en platform.kimi.ai, porque un modelo puede retirarse o cambiar de precio.
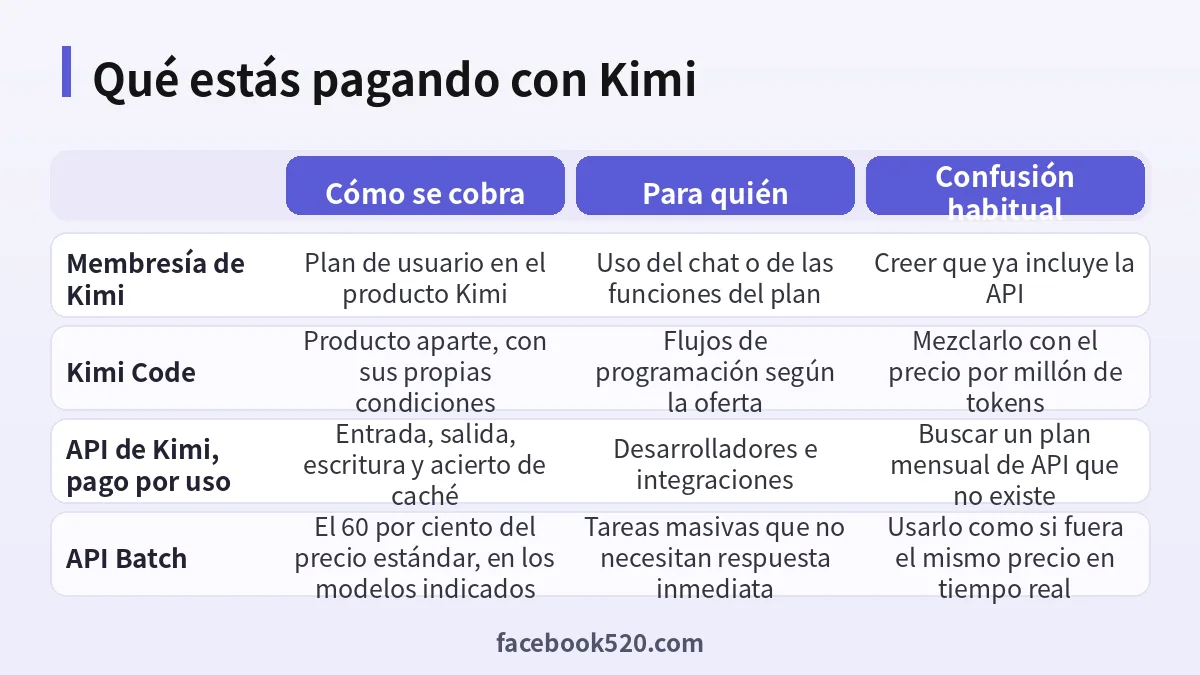
La API no es la membresía, ni Kimi Code
Kimi, como producto de chat, puede tener planes de membresía para usar la aplicación. Kimi Code es otro producto, con sus propias reglas. La Kimi API Platform factura la inferencia de modelos cuando tu aplicación llama a la API: prompts, historial, documentos extraídos que envías como entrada, y la salida generada, incluidos razonamientos cuando el modelo los produce.
Si alguien te vende un “plan Kimi API mensual” con un precio fijo que no aparece en la documentación de inferencia, no lo tomes como tarifa oficial. Lo oficial es el pago por tokens, con descuentos de caché y, en ciertos modelos, una API Batch más barata.
También hay que seguir el calendario de los modelos antiguos. La documentación indica que, desde el 31 de octubre de 2026, la serie K2 dejó de estar disponible para usuarios recién registrados, que los usuarios ya existentes no se ven afectados de inmediato, y que está previsto retirar la serie K2 a finales de diciembre de 2026. Para un proyecto nuevo, no bases un presupuesto en K2.
Precios oficiales consultados el 20 de noviembre de 2026
Según la plataforma oficial y la documentación de inferencia, la serie K3 admite una ventana de contexto de 1.048.576 tokens. La caché de contexto se activa de forma automática para prefijos repetidos, con un TTL predeterminado de 5 minutos. La escritura de caché y el acierto se cobran por separado; un token de entrada entra en una sola de esas categorías, no se cobra dos veces como entrada normal y como escritura.
Kimi K3.1 Pro (kimi-k3.1-pro): 2,00 dólares de entrada, 10,00 dólares de salida, 2,00 dólares de escritura de caché y 0,20 dólares por acierto de caché, en cada caso por millón de tokens. Es el modelo insignia de la serie K3.1 en la página de la plataforma.
Kimi K3.1 Pro Highspeed (kimi-k3.1-pro-highspeed): 4,00 dólares de entrada, 20,00 dólares de salida, 4,00 dólares de escritura de caché y 0,20 dólares por acierto. La plataforma lo presenta como una variante más rápida, con la misma ventana de contexto, a un precio claramente superior en entrada, salida y escritura. El acierto de caché se mantiene en 0,20 dólares, así que un tráfico con mucho prefijo reutilizado no se duplica de forma automática en todos los conceptos.
Kimi K3 (kimi-k3): 3,00 dólares de entrada, 15,00 dólares de salida, 3,00 dólares de escritura de caché y 0,30 dólares por acierto, por millón de tokens.
La documentación indica además que kimi-k3.1-pro y kimi-k3 admiten inferencia por lotes (Batch) para tareas masivas que no necesitan respuesta en tiempo real, al 60 por ciento del precio estándar. El centro de ayuda de la API menciona un cargo adicional de 0,004 dólares por invocación de búsqueda web, independiente del consumo de tokens. Si usas esa herramienta, súmala al cálculo; no está incluida en el precio de entrada.
Otras líneas, como una escritura de caché con TTL de una hora, pueden aparecer en materiales de apoyo de Kimi. Si tu integración cambia el TTL, confirma esa fila en la documentación oficial del día, no la des por sentada a partir de un resumen.
| Modelo (plataforma oficial, 20 nov. 2026) | Entrada / salida, USD por millón de tokens | Caché (escritura / acierto) |
|---|---|---|
| Kimi K3.1 Pro | 2,00 / 10,00 | 2,00 / 0,20 |
| Kimi K3.1 Pro Highspeed | 4,00 / 20,00 | 4,00 / 0,20 |
| Kimi K3 | 3,00 / 15,00 | 3,00 / 0,30 |
| Concepto | Cómo se cobra | No lo confunda con |
|---|---|---|
| API de inferencia | Pago por uso de tokens | Una suscripción mensual de API |
| Membresía de Kimi | Plan del producto de consumo | El saldo de la API |
| Batch (modelos indicados) | 60 por ciento del precio estándar | El mismo precio en tiempo real |
| Búsqueda web | Cargo por invocación, según el centro de ayuda | El precio de entrada del modelo |
Cómo estimar el coste sin inventar una cuota mensual
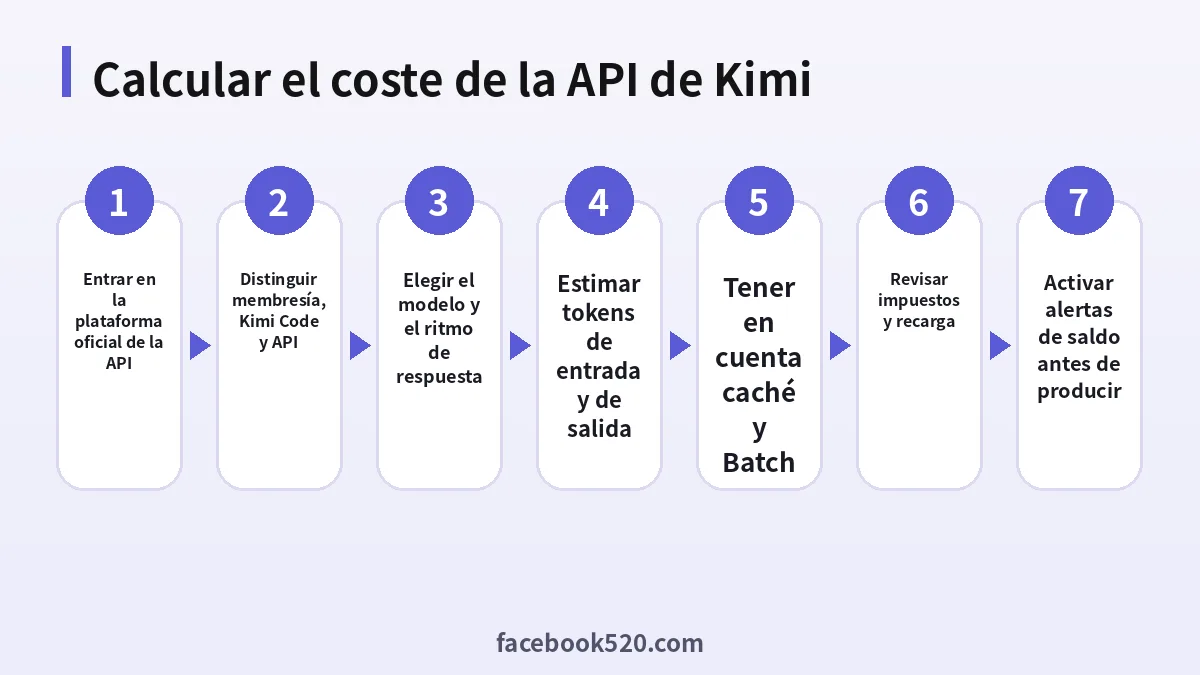
Una estimación honesta parte de cinco cifras: tokens de entrada no cacheados, tokens escritos en caché, tokens que aciertan caché, tokens de salida y, si aplica, invocaciones de búsqueda o de Batch.
- Mide un lote real de prompts con la herramienta de recuento de tokens de la propia plataforma, en lugar de adivinar “una palabra, un token”. En inglés la documentación habla de unos 3 o 4 caracteres por token, pero el recuento exacto sale de la API de cálculo.
- Separa el sistema y los documentos fijos, que pueden beneficiarse de la caché, del turno variable del usuario.
- Multiplica cada bloque por su tarifa y divide entre un millón.
- Si la tarea puede esperar, calcula la misma carga en Batch al 60 por ciento y compara el ahorro con el retraso.
- Si necesitas menor latencia, compara K3.1 Pro estándar con Highspeed solo en el tráfico interactivo, no en los lotes nocturnos.
- Añade impuestos y un margen para reintentos o salidas más largas de lo previsto, sobre todo si el modelo razona por defecto.
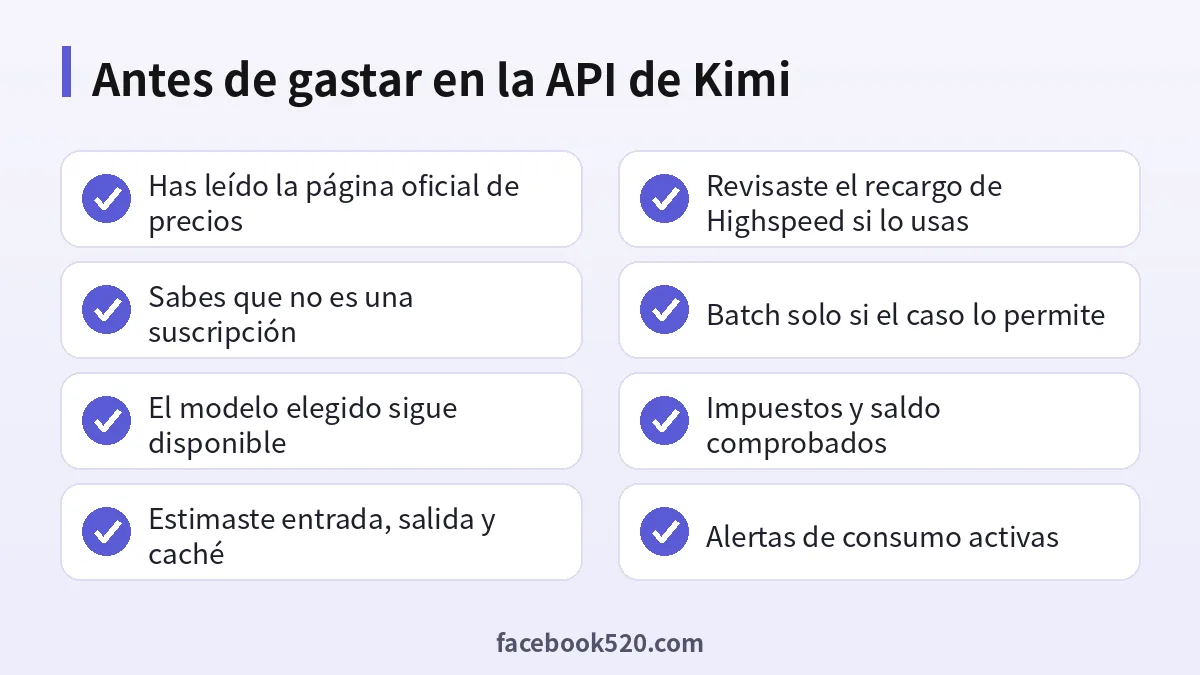
- Pon un tope de saldo o alertas antes de pasar a producción.
Errores frecuentes al leer Kimi API pricing
El más habitual es tratar la API como si fuera la membresía. El segundo es presupuestar solo la entrada y olvidar que la salida de K3.1 Pro cuesta cinco veces más por millón que la entrada estándar. El tercero es activar Highspeed en todo el tráfico porque “va más rápido”, cuando una parte podría ir en el modelo estándar o en Batch.
También se pierde dinero cuando el prefijo cambia al principio y la caché deja de acertar, o cuando se adjunta un documento entero en cada llamada en lugar de reutilizar un contexto estable. La documentación aclara que, si extraes un archivo y envías ese texto como entrada, ese contenido también se cobra por uso; las interfaces de extracción y almacenamiento de archivos pueden estar temporalmente exentas, pero el texto enviado al modelo no lo está.
Por último, no copies a un cliente un precio “oficial en euros” redondeado. La tarifa está en dólares; tu banco o la pasarela aplicarán el cambio y los impuestos. El importe a consignar en un contrato es el de la tabla oficial más esa aclaración, no una cifra inventada en moneda local.
Un ejemplo de cálculo, sin convertirlo en precio fijo
Imagina un asistente que, en un mes, envía 20 millones de tokens de entrada no cacheados, 80 millones que aciertan caché, 5 millones escritos en caché con el TTL predeterminado y 8 millones de tokens de salida, todo en K3.1 Pro estándar. Con las tarifas consultadas el 20 de noviembre de 2026, la entrada normal serían 40 dólares, los aciertos de caché 16 dólares, la escritura 10 dólares y la salida 80 dólares. El subtotal, 146 dólares antes de impuestos y de cualquier búsqueda web. Si esa misma carga pudiera ir por Batch en un modelo elegible, el 60 por ciento del estándar bajaría de forma notable el conjunto, a costa de esperar el resultado. Si en cambio pasas el tráfico interactivo a Highspeed, la entrada, la salida y la escritura se duplican, y el acierto de caché se queda en 0,20 dólares por millón.
Este ejemplo no es una oferta ni un plan. Sirve solo para ver cómo un cambio de modo altera la factura mucho más que un redondeo en euros. Si tus volúmenes son distintos, no escales esta cifra a ojo: vuelve a medir tokens en tu propio tráfico, porque un sistema con historiales largos o con documentos adjuntos en cada turno se parece poco a un chatbot de frases cortas.
También ayuda registrar, junto al gasto, la calidad obtenida. Highspeed no vale la pena si el usuario no nota la diferencia de espera, y Batch no vale la pena si el equipo acaba relanzando las mismas tareas en modo síncrono “porque urge”. El precio oficial es claro; el desperdicio suele estar en la forma de llamar a la API.
Cómo abrir y vigilar la cuenta de la API
El alta se hace en la plataforma oficial de la API, con una cuenta que controles y, en una empresa, con un responsable de facturación que no sea una dirección personal de un empleado que pueda irse. Recarga o activa el saldo según el flujo que muestre la web ese día, guarda los comprobantes y configura avisos cuando el consumo se acerque a un tope interno. No hace falta publicar la clave en un backend expuesto ni compartirla por un chat de grupo.
Si el proyecto es para un cliente, acuerda por escrito qué modelos están autorizados y qué ocurre si Kimi cambia un precio o retira un modelo. Esa cláusula es más útil que discusiones sobre un “precio cerrado a un año” que la tarifa por uso no puede garantizar. Revisa la tabla otra vez el día en que firmes, no solo el día en que escribiste el primer borrador de esta guía.
En el día a día, un buen hábito es exportar o copiar el desglose de uso una vez por semana durante el primer mes de producción. Así detectas pronto si un trabajo programado se ha duplicado, si un prompt de sistema ha crecido sin control o si alguien ha dejado Highspeed como valor por defecto en un entorno de pruebas. Corregir eso cuesta minutos; descubrirlo en la factura de fin de mes cuesta mucho más, aunque el precio por millón de tokens no haya cambiado ni un céntimo respecto a la tabla oficial.
Si además usas la API en más de una región o para más de un producto, etiqueta los proyectos desde el principio. Mezclar el tráfico de un prototipo interno con el de un cliente final hace imposible explicar un cargo y casi imposible aplicar Batch solo donde corresponde. Esa separación simple evita discusiones posteriores sobre un cargo que, en realidad, nunca debió mezclarse.
Preguntas frecuentes
La API de Kimi tiene suscripción mensual?
No. La documentación de inferencia indica un cobro por uso, distinto de la membresía de Kimi y de Kimi Code. Si tu uso es estable, puedes estimar un gasto mensual, pero eso no convierte la tarifa en un plan oficial de suscripción.
Cuánto cuesta Kimi K3.1 Pro?
Según la plataforma consultada el 20 de noviembre de 2026, 2,00 dólares por millón de tokens de entrada, 10,00 de salida, 2,00 de escritura de caché y 0,20 por acierto de caché, antes de impuestos.
Cuándo merece la pena Highspeed?
Cuando la latencia importa, por ejemplo en un asistente interactivo. Cuesta el doble en entrada, salida y escritura de caché respecto a K3.1 Pro estándar, con el acierto de caché en 0,20 dólares. Mide antes de migrar todo el tráfico.
El Batch es siempre más barato?
En los modelos indicados, el precio es el 60 por ciento del estándar, a cambio de no tener una respuesta inmediata. Si tu producto necesita el resultado al instante, Batch no aplica.
La membresía de Kimi cubre la API?
No. La membresía cubre los beneficios de ese plan de producto. La plataforma de la API cobra el consumo de tokens por separado.
Qué pasa con los modelos K2?
Dejaron de abrirse a usuarios nuevos el 31 de octubre de 2026 y está prevista su retirada a finales de diciembre de 2026, según la nota oficial. Un proyecto nuevo debe presupuestar la serie K3.
La búsqueda web está incluida en el precio del modelo?
El centro de ayuda indica un cargo de 0,004 dólares por invocación, independiente de los tokens. Confirma esa línea si tu agente busca en la web.
Cómo se cuenta un token?
Es la unidad interna del modelo. La forma precisa es usar la API de cálculo de tokens. No bases un contrato en un recuento casero de palabras.
Puedo pagar en euros?
La tarifa de referencia está en dólares. El cargo en tu moneda depende de la pasarela y del banco, con sus comisiones y de impuestos. Revisa el total en el momento de recargar o de recibir el extracto.
Qué impuestos se aplican?
La documentación indica que los precios no incluyen los impuestos aplicables y que se calculan según tu jurisdicción. No los omitas en un presupuesto para un cliente europeo.
Dónde comprobar el precio el mismo día?
En platform.kimi.ai y en la documentación de precios de inferencia. Esta guía está fechada el 20 de noviembre de 2026 y no sustituye la tabla viva.
Cómo compararlo con Claude, Gemini o Grok?
Compara entrada, salida, caché, herramientas y si existe un plan de suscripción o solo pago por uso. Las guías enlazadas más arriba ayudan a navegar, pero el número que cuenta es el de la página oficial de cada proveedor.
Si trabajas en un equipo, deja por escrito qué modelo es el predeterminado, quién puede activar Highspeed y qué proyecto usa Batch. Esa norma interna evita que cada desarrollador elija el modo más rápido “por si acaso” y que la factura se dispare sin que el producto lo necesite. También conviene separar las claves de prueba y de producción, y no incrustarlas en repositorios públicos: una clave filtrada gasta saldo con la misma tarifa oficial, solo que sin control.
Cuando presentes cifras a un cliente, añade la fecha de consulta y el enlace a la documentación. Un PDF con un precio copiado hace tres meses no es una fuente. En un mercado donde los modelos se retiran, como ocurre con K2 a finales de 2026, la fecha es parte del precio.
Conclusión
Kimi API pricing en 2026 se entiende mejor como una tarifa por tokens, no como un abono mensual. Los precios oficiales consultados el 20 de noviembre de 2026 sitúan K3.1 Pro en 2 y 10 dólares por millón de tokens de entrada y de salida, Highspeed al doble en varios conceptos, y K3 en 3 y 15, con caché y un Batch al 60 por ciento en los modelos indicados. Distingue esa factura de la membresía y de Kimi Code, mide los tokens de verdad, activa alertas de saldo y vuelve a leer la tabla oficial antes de cerrar un presupuesto, sobre todo si tu plan todavía menciona la serie K2.
